从数据采集到模型部署 一个产品落地的全流程实战
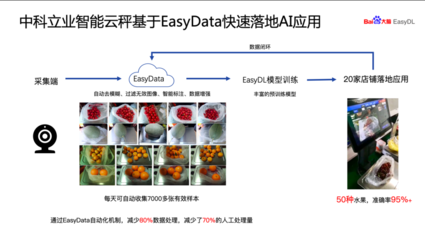
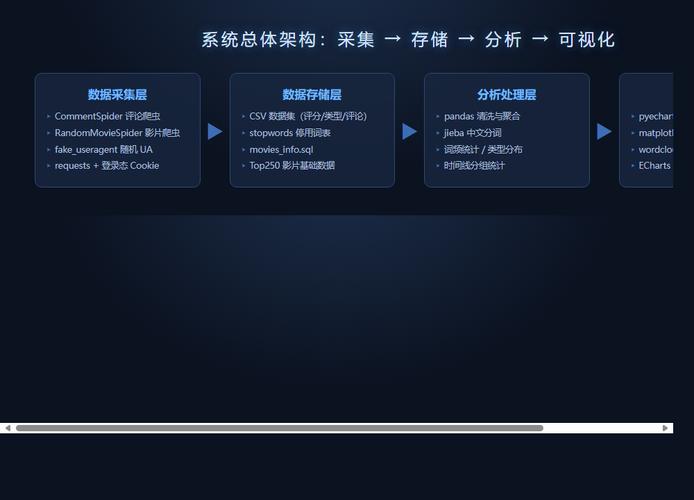
在人工智能产品落地的过程中,很多团队把精力集中在模型结构的选择和调参上,却忽略了最关键的基础——数据。本文将按照数据采集、清洗、标注、模型训练和部署的顺序,系统分享我在产品落地中的实战经验,并重点展开容易被低估的数据环节。
一、数据采集:明确目标,多源获取
数据采集是整条链路的第一步,也是最容易“埋雷”的环节。如果采集阶段目标模糊、来源混乱,后续的清洗和训练会付出成倍的代价。
1. 先定义问题,再定义数据
在动手采集之前,我首先明确三个问题:产品要解决什么任务(分类、检测还是生成)?样本需要覆盖哪些场景和长尾情况?上线后数据分布可能与训练数据有多大偏差?带着这些问题制定采集计划,才能避免“采集了一堆数据却用不上”的困境。
2. 多源采集策略
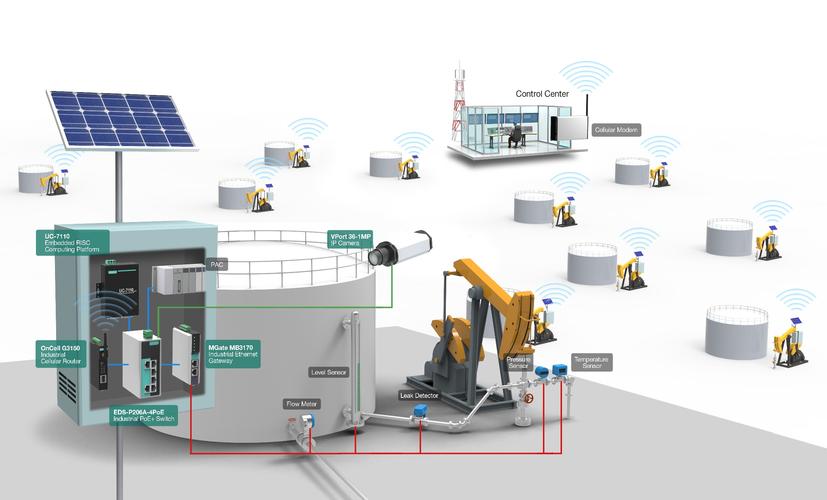
实际业务中,数据来源往往是多路的。我采用了组合策略:业务系统已有的日志和业务数据是成本最低的来源;公开数据集适合快速验证;问卷调查和人工整理用于补充稀缺类别;传感器或用户行为埋点用于获取线上增量数据。多源采集的核心原则是“能用存量绝不复采”,优先把已有数据盘活。
3. 重视多样性与代表性
采集时我有意识地保证数据的多样性:覆盖不同用户群体、不同时间、不同设备和使用场景。��对长尾场景单独采样,避免数据集反映的是产品或真实场景所不具备的特征。这样一来,样本分布的漂移明显减少,也更贴合线上实际表现。
4. 同步做好数据管理规范
采集阶段就建立统一的命名规范、目录结构和元信息记录机制(字段含义、采集时间、来源和采集人)。每个样本预留可由程序标识的唯一线索或落盘时的稳定元数据,元数据可由文件命名或采集清单JSON维护,每批数据入库时分配稳定内部ID,供标注、汇��和训练阶段分层抽样追溯到原始批次,清理误标时也能精准定位。从一开始就管好数据,可以为后续全链路所依赖的准确性提速不少。
如若转载,请注明出处:http://www.zcshe.com/product/33.html
更新时间:2026-11-01 22:55:13